Ein Taschenrechner, vier Bauweisen: Was kosten Agenten-Schleifen, und was bringen sie?
Ich habe einen Taschenrechner von 1974 viermal von KI-Agenten bauen lassen, vom schnellen Wurf bis zum parallelen Graphen, und alle vier blind gleich bewerten lassen. Was die Zahlen zeigen und woher die Qualität am Ende kam.
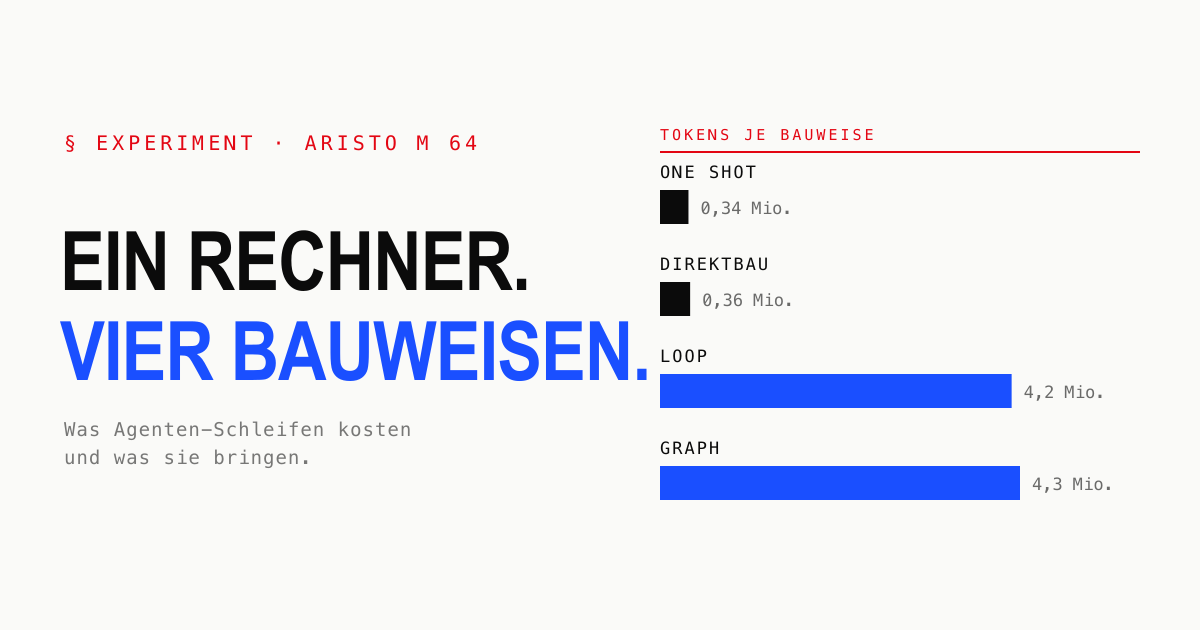
Am Samstagmorgen um kurz vor zehn habe ich neun Sätze in Claude Code getippt, mit Tippfehlern. Ein Taschenrechner für den Browser, der aussieht und sich anfühlt wie ein klassischer Aristo. Gebaut von Agenten, im Spec-Eval-Muster, Feature für Feature in einer expliziten Schleife, bis alles grün ist. Das Look and Feel sollte spezifiziert und testbar sein.
Der Aristo M 64 kommt aus Hamburg, Baujahr 1974: mattschwarz, mit cremeweißer Schutzhülle, roter LED-Anzeige und Tasten, die satt klacken. Er kann die vier Grundrechenarten, Wurzel und Prozent. Mehr nicht. Ich hab ihn damals zu Weihnachten geschenkt bekommen. Stolz wie Bolle. 120 DMark. Ein überschaubares Projekt, dachte ich. Genug, um eine Methode zu testen.
Derselbe Rechner, auf vier Arten gebaut
Eigentlich wollte ich Agentic Loop Engineering ausprobieren, wohlwissend, dass ich die Konzepte zwar grob verstehe, aber im Detail selbst seit ca. 20 Jahren nicht mehr wirklich entwickelt habe. Also Agenten, die Feature für Feature bauen, ein unabhängiger Prüfer, ein Gutachter für das Aussehen, ein Aufräumer für den Code. Um zu wissen, was das wert ist, brauchte ich Vergleiche. Also habe ich den Rechner viermal bauen lassen:
- One Shot. Ein Agent, mein Prompt, die Fotos, ein Durchgang. So, wie man das mal eben ausprobiert.
- Direktbau. Auch ein Agent und ein Durchgang, aber mit dem kompletten Bauplan: Spec mit Maßen, Feature-Liste, Projekthinweise.
- Loop. Die Schleife: 15 Features in zwei Stufen, jedes gebaut, geprüft, begutachtet und festgehalten, alle paar Features eine Aufräumrunde.
- Graph. Dieselbe Schleife, parallel. Ein Architekt schneidet den Rechner in Einheiten mit Verträgen, bis zu drei Spuren bauen gleichzeitig, eine Merge-Queue führt sie zusammen.
Ich weiß, das klingt alles super advanced und wie „warum kann der das“, aber ich schwöre: Ich musste nichts davon bauen. Ich wollte genau die Aussage „Ich baue keinen Prompt, sondern ich baue das System, das Claude Code promptet“ testen. Das war der Punkt. Weil ich dachte: Genau das kommt meiner Unkenntnis entgegen. Und siehe da, das klappt. Ich will sagen: Mein Skill war eher Mut, Neugier und Experimentierwille als alles andere. Und ganz ehrlich: Bei den Graphen hätte ich fast aufgegeben.
Am Ende hat jeder Rechner dieselbe Bewertung bekommen, und die Gutachter wussten nicht, wer was gebaut hatte: Vergleich mit den Fotos, eine freie Funktionsprobe mit zehn Rechnungen, ein Code-Gutachten und eine Einschätzung, wie gut man darauf weiterbauen kann.
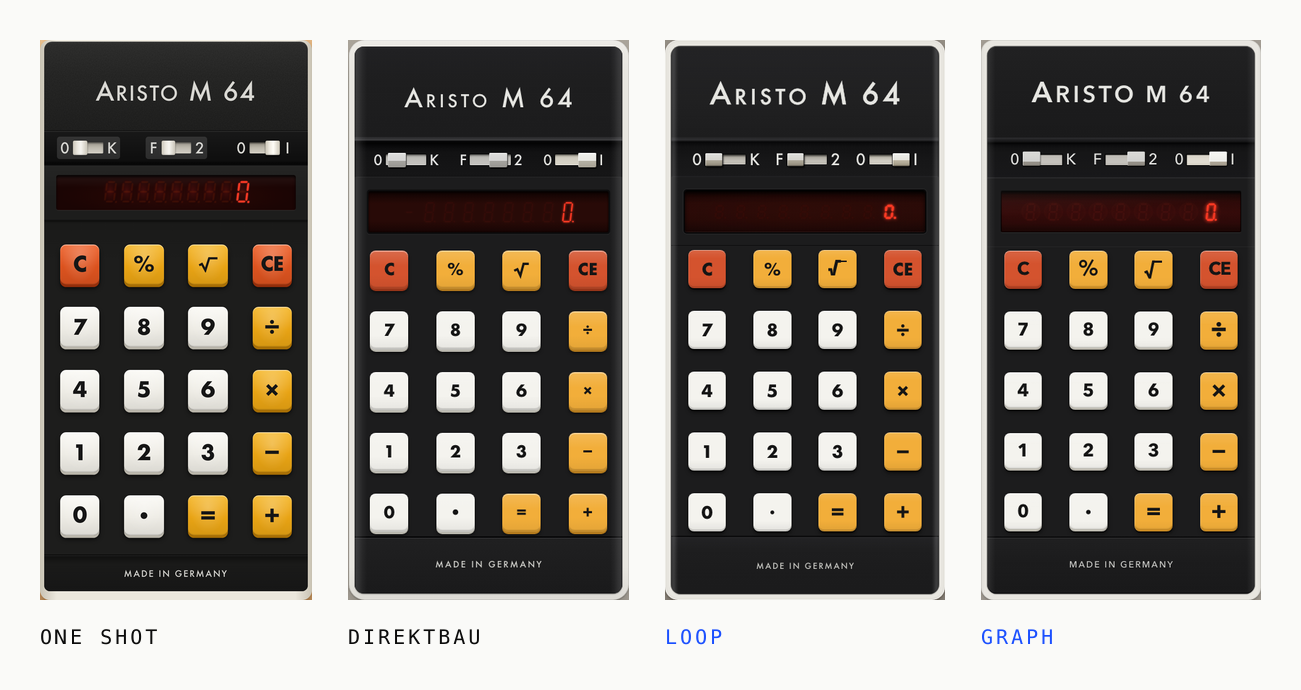 Vier Bauweisen, vier Rechner. Von links: One Shot, Direktbau, Loop, Graph.
Selbst ausprobieren
Alles aus diesem Artikel liegt in einem Repo: der Rechner, Spec und Eval, die vier Bauweisen und die Werkstatt-Seite mit allen Protokollen. Herunterladen oder forken, in Claude Code öffnen, und jede Bauweise lässt sich per Knopfdruck selbst bauen.
Repo auf GitHub →git clone https://github.com/ueberproduct-lab/aristo-m64.git
dann in Claude Code: /aristo-experience
Zwölfmal so teuer, und trotzdem vorn
Der One Shot war nach elf Minuten fertig und hat rund 340.000 Tokens verbraucht. Die Schleife brauchte knapp zweieinhalb Stunden und 4,2 Millionen Tokens. Gut tausend Zeilen Code für über vier Millionen Tokens: Das ist unanständig, und es fühlt sich beim Zuschauen auch so an.
Trotzdem gewinnt die Schleife bei allem, was zählt, wenn man länger mit einem Produkt leben will. Treue zum Vorbild: 20 von 20 Punkten beim Loop, 14 beim One Shot. Absicherung: 106 versiegelte Anforderungen, alle grün, und jede Prüfung läuft auf Knopfdruck wieder. Struktur: der aufgeräumteste Code im Vergleich.
Gerechnet haben alle vier richtig, zehn von zehn. Daran lag es also nicht. Und der Direktbau ist erstaunlich weit gekommen: 22 Minuten, 17 von 20 Punkten beim Aussehen, 103 von 106 Anforderungen. Ein guter Bauplan macht schon sehr viel.
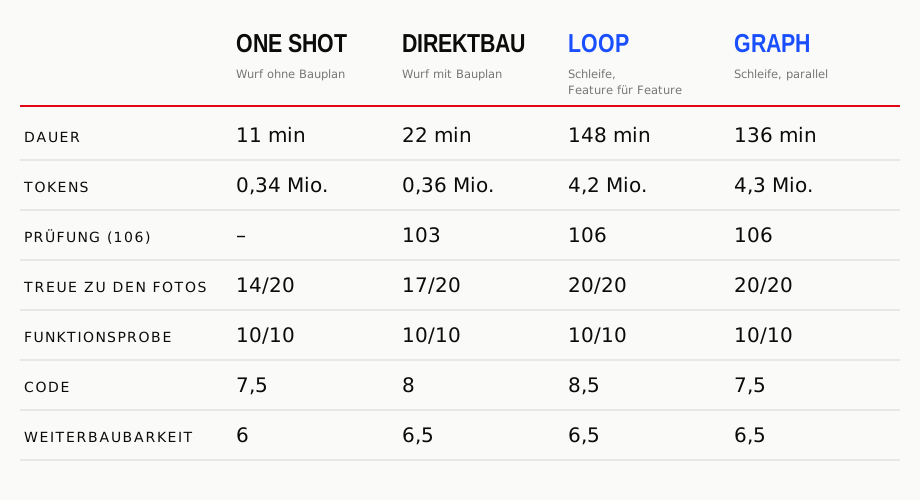 Alle vier gleich und blind bewertet. Die versiegelte Prüfung kennt der One Shot nicht, deshalb kein Wert.
Woher die Qualität kam
Die eigentliche Erkenntnis liegt woanders. Dass das Weiße am Original eine abnehmbare Hülle ist, dass der Klick satt klingen muss, aber leise, dass die Schieber erhaben sind: Nichts davon stand in meinen neun Sätzen. Es kam in den Bau, weil ich hingesehen und hingehört und dann gesagt habe: so nicht.
Kent Beck hat beschrieben, dass der Wert von neunzig Prozent seiner Fähigkeiten auf null gefallen ist, während die Hebelwirkung der übrigen zehn Prozent um ein Vielfaches gestiegen ist. In diesem Projekt kann man ziemlich genau sehen, was diese zehn Prozent sind: hinsehen, entscheiden, verantworten.
Ein kleines Beispiel dafür. Irgendwann stand in der Spec, dass das Wurzelzeichen einen angeschlossenen Querstrich haben soll, wie auf dem Foto. Die Schleife hat geliefert, alle Prüfungen grün. Angesehen habe ich es mir trotzdem: Beim Loop sitzt der Strich als eigener Strich über dem Haken, ein bisschen abgesetzt, mit einem Knick. Die Prüfung war zufrieden, mein Auge nicht. Grün und gut sind zwei verschiedene Dinge.
Damit erklärt sich auch der Unterschied zwischen den Bauweisen. Der One Shot bekommt mein Urteil einmal, vorher, und nie wieder. Die iterierenden Bauweisen haben einen Kanal, über den es in jeden weiteren Schritt fließt und dort bleibt: Bauplan mit Nummern, versiegelte Prüfung, Gutachter, Schleife. Möglich macht das die Engineering-Struktur drumherum. Ab dem Moment, in dem mein Urteil festgehalten ist, können die Agenten fast alles, was ich kann, oft mehr, schneller und billiger.
Der Graph hat fast nichts besser gemacht
Am meisten überrascht hat mich der Graph. Bis zu drei Spuren gleichzeitig, ein Architekt, der den Rechner selbst schneidet, eine Merge-Queue mit Integrator, der Konflikte zwischen den Spuren löst. Und am Ende: 136 statt 148 Minuten, gleiche Tokens, gleiche Noten.
Warum, zeigt erst die Zeitanalyse. Das Bauen selbst lief 1,65-mal so schnell: 124 Minuten Bauarbeit, verteilt auf parallele Spuren, in 75 Minuten. Fast genau diese Ersparnis hat die Koordination wieder aufgezehrt. Architekt und Gerüst, Zusammenführen, nach jeder Spur die komplette Prüfung: zusammen 48 Minuten.
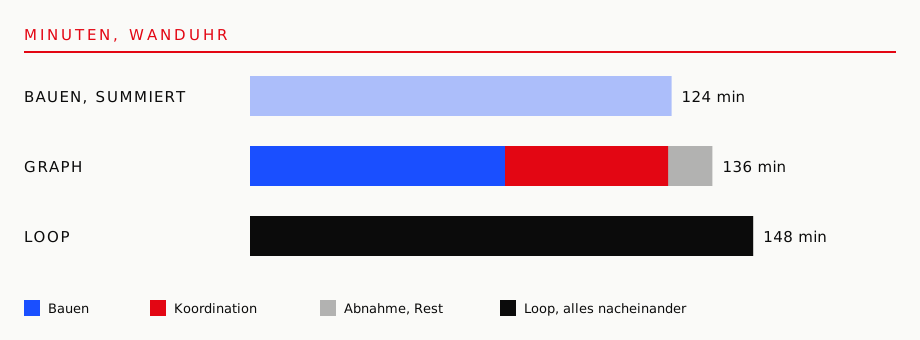 Parallel gebaut spart 49 Minuten, die Koordination kostet 48. Am Ende 136 statt 148 Minuten.
Für einen Taschenrechner ist das zu viel Maschine. Ein Bildschirm, ein eingefrorenes Gesamtbild als Referenz, eine Rechenkette, die nur nacheinander geht: Da kann wenig wirklich unabhängig laufen. Dazu kommt, dass es zwei Tage gedauert hat, den Graphen zuverlässig zum Laufen zu bringen. Gebaut haben die Agenten dabei gut. Gestolpert ist jedes Mal die Maschine drumherum, also Rechte, Zusammenführen und wackelige Tests.
Boris Cherny, der Claude Code baut, arbeitet anders herum: kleine Features in einem riesigen, bestehenden Produkt. Seine Aufträge sind ein paar Sätze. Etwa, dass eine gesendete Nachricht im Terminal grau bleibt, bis das Modell sie angenommen hat, plus der Hinweis, wie das Produkt so etwas an anderer Stelle schon macht. Schnitt, Verträge und Prüfungen gibt es dort längst, sie müssen nicht bei jedem Auftrag neu entstehen. Dann rechnet sich die Schleife, und dann auch der Graph.
Was ich über die Schleifen gelernt habe
Erstens: Der Aufräum-Schritt ist wesentlich. Ohne ihn wird der Code mit jedem Feature ein bisschen breiter und ein bisschen unklarer, auch wenn alle Prüfungen grün bleiben. Die Schleife hatte am Ende den saubersten Code im Vergleich. Dort tut ein eigener Agent alle paar Features nichts anderes, als aufzuräumen, gegen dieselben Prüfungen.
Zweitens: Determinismus in den Schleifen ist die Rettung. Solange Agenten auch die mechanischen Schritte erledigt haben, also Daten abschreiben, Dateien verschieben, Prüfungen anstoßen und das Ergebnis weitererzählen, war Chaos. Ein Prüfer hat einmal 79 von 79 gemeldet, wo der Bericht 46 von 79 sagte. Ein anderer hat einfach die ganze Suite laufen lassen statt der Auswahl. Stabil wurde die Werkstatt erst, als jeder feste Schritt ein Skript war, das genau eine prüfbare Antwort gibt. Aha, deswegen reden alle davon.
Aber dann kommt der zweite Teil: Innerhalb der Schleifen geht trotzdem etwas schief. Eine Spur stürzt ab, zwei Features ändern dieselbe Datei, die Prüfung selbst läuft nicht an. Dafür braucht es wieder ein Sprachmodell, das nachsieht, versteht und rettet. Im Graphen macht das ein Integrator bei Konflikten und ein Engineering Manager, wenn die Regeln des Skripts am Ende sind. Also: Determinismus da, wo es geregelt sein muss. Nicht-Determinismus und Intelligenz da, wo gerettet werden muss. Und dann viel Autonomie geben.
Das Verblüffendste daran: Obwohl ich seit 20 Jahren nicht mehr richtig entwickle, konnte ich das alles ableiten und Claude Code allein durchs Reden dorthin bringen. Bestimmt kann man das im Detail alles besser machen. Darum ging es hier aber nicht.
Die Leiter: je höher, desto ausbaubarer
Es gibt den Verdacht, dass die großen KI-Labore so viel über Loops und Graphen reden, weil sie Tokens verkaufen wollen. Kann sein. Was ich hier sehe, ist etwas anderes: Mit jeder Engineering-Technik wird das Spektrum breiter. Es reicht vom Wurf für elf Minuten über den präzisen Bauplan und die geprüfte Schleife bis zum parallelen Graphen. Und ganz am anderen Ende stehen null Tokens, weil ein Mensch es selbst baut.
Je weiter man diese Leiter hochklettert, desto ausbaubarer wird das Ergebnis. Am Code selbst sieht man das kaum: Der One Shot und der Graph haben dieselbe Code-Note bekommen, 7,5. Der Unterschied ist das Netz darunter. Beim One Shot gibt es keins, der Gutachter gab 1,5 von 10. Alle anderen haben einen Bauplan mit Nummern und versiegelte Prüfungen und liegen bei 6 bis 6,5. Und der Wert entsteht ohnehin erst danach, in den Iterationen. Bei uns waren das acht Verfeinerungen in Stufe 2, Hülle, Klang, Feinschliff, und alle 106 Prüfungen blieben grün. Viele Iterationen werden erst mit den höheren Vorgehensweisen möglich und wartbar. Den One Shot haben wir nie weiterentwickelt, aber ohne Netz dürfte jede Änderung ein kleines Glücksspiel sein.
Umgekehrt taugen die oberen Stufen nicht für den schnellen Wurf. In Loops und Graphen vibe-codet man nicht. Das wäre die unökonomischste Entscheidung von allen.
Wie man das alles bewertet, hängt am Qualitätsanspruch. So albern das Beispiel mit dem Aristo sein mag: Wer daran irgendetwas wertig und emotional haben will, findet den Wert in den Verfeinerungen. Die Hülle, der Klick, die Schieber, und es kämen noch viele weitere. Für echtes Produktmanagement heißt das: Man kann nur hoffen, dass die Engineers sich bis zu den höheren Stufen weiterentwickeln dürfen. Erst dann ist man in der Lage, solche Verbesserungen an Produkten immer wieder vorzunehmen.
Gleichzeitig ist der One Shot für Vorstufen großartig. Wahnsinn, welche Prototypen man inzwischen selbst bauen kann. Und für Zwischenstufen, die noch nicht deployed werden müssen, ist der Direktbau unschlagbar im Verhältnis von Qualität, Kosten und Zeit: 22 Minuten, 0,36 Millionen Tokens, 17 von 20 Punkten beim Aussehen.
Wer ein Produkt über Jahre betreiben will, wer zwanzig Agenten in zwanzig Repos Dinge bauen lässt, die zusammenpassen müssen, braucht das Gerüst. Dann rückt der One Shot eine Ebene nach innen und wird zum Arbeitsschritt in einer abgesicherten Spur.
Was übrig bleibt
Ein großer Versuchsaufbau für einen kleinen Rechner. Gelernt habe ich weniger über Loops als über die Frage, welcher Teil meiner Arbeit übrig bleibt, wenn das Bauen fast nichts mehr kostet. Es ist der Teil, der Qualität erkennt, bevor sie jemand messen kann.
Selbst bauen lassen
Lad dir das Repo runter, schau dir die Werkstatt an und lass einen der vier Wege selbst bauen. Vielleicht spinne ich ja. Beurteile selbst.
Repo auf GitHub →git clone https://github.com/ueberproduct-lab/aristo-m64.git
dann in Claude Code: /aristo-experience